你叫 AI 做的事,一半其實只需要它回一個字:Jev 是什麼、社群這一週拿它做了什麼、怎麼幫你省 token
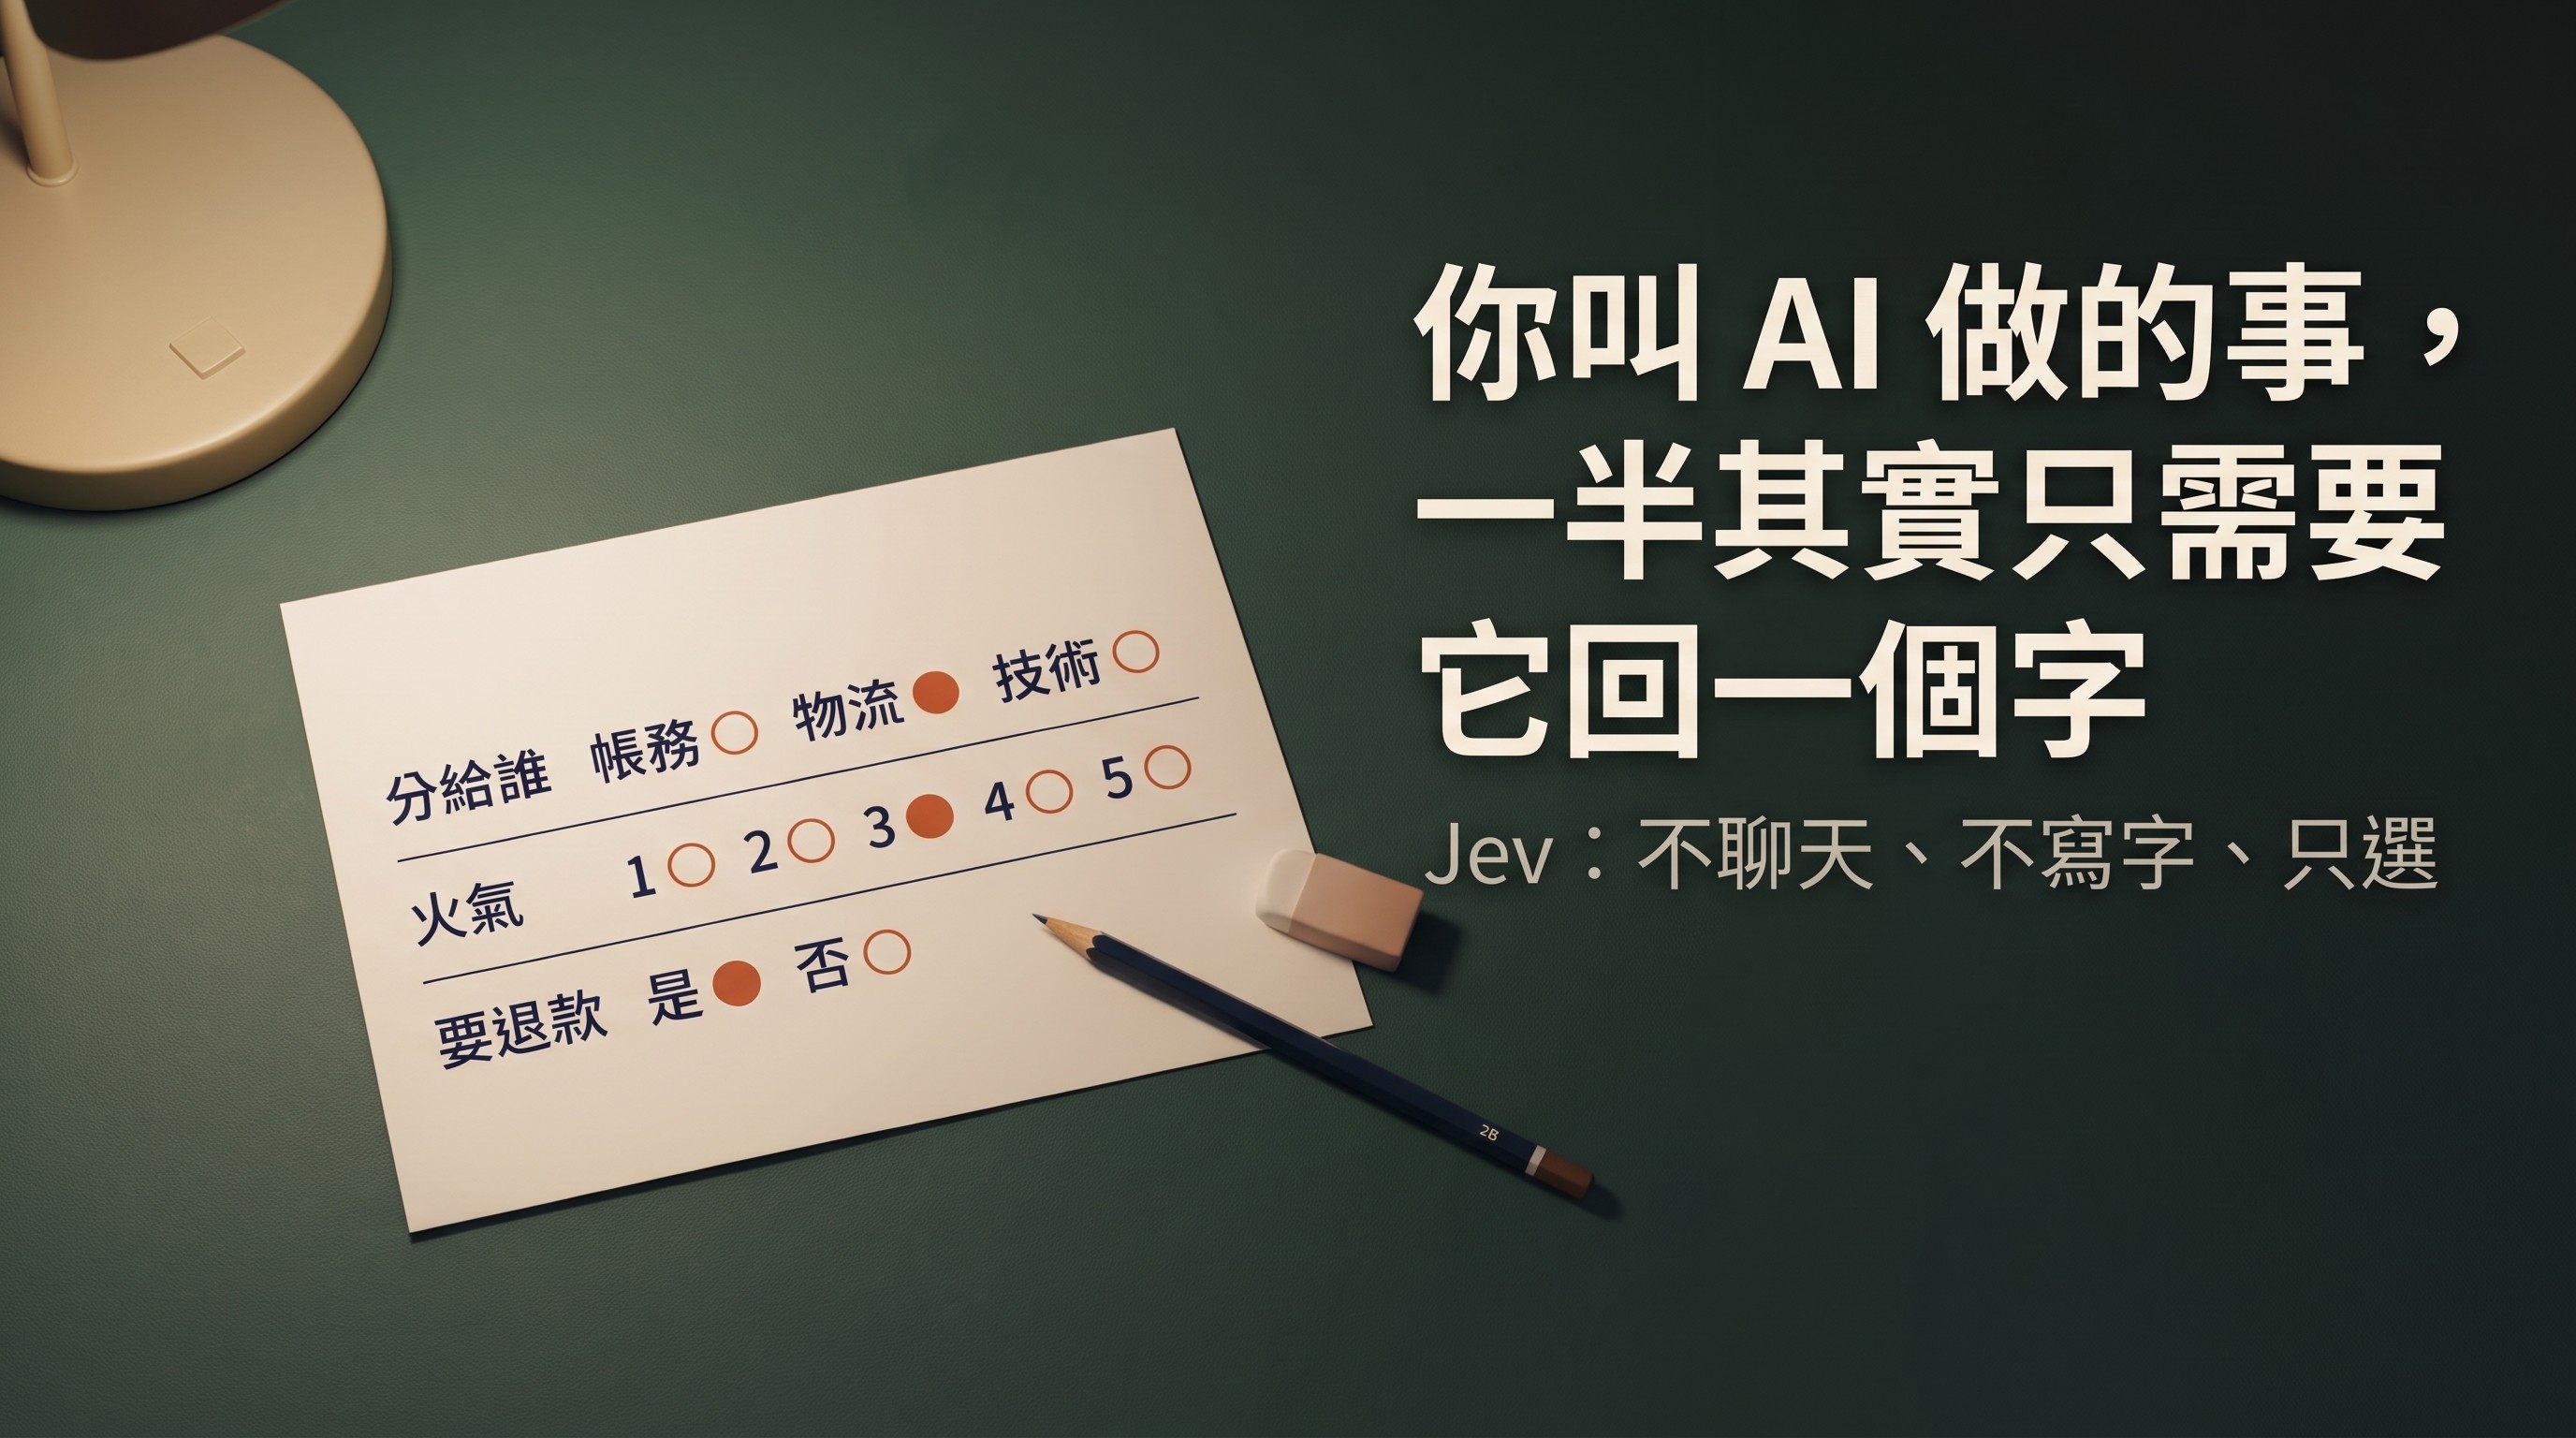
你每天丟給 ChatGPT 的事,有一半其實只要它回一個字:是、不是、A 還是 B、幾分。這封信要不要回、這則留言是問問題還是廣告、這份履歷先看還是後看、這則簡訊是不是詐騙。你拿聊天模型做這種事,它會先寫一段理由給你看,慢,也貴,你還要從那段理由裡把答案撈出來。
9 月 15 日一家叫 TypeSafe AI 的新創把「那一半」做成一個模型,叫 Jev。給它文字跟幾個答案,它零點幾秒回你是哪一個、多有把握;一個字,不多。創辦人 Diogo Almeida 在發表文裡自己寫:在 OpenAI 的時候,他做的是讓語言模型聽得懂指令、能跟人講話的方法,「That work ended up as the research behind ChatGPT.」他花了兩年做的這個東西,走的是相反的路。
Jev 是什麼:不生字,只回一個字
一般模型是一個字一個字往下生,所以你要等。Jev 不生字:你先把答案給它,它把每個答案的機率一次算出來,回你「是哪一個、多有把握」。TypeSafe 的講法是「Think of Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out.」
它只認三種題型,也就是一個字能做的三件事,我用一封客服信舉例:
- 哪一個(Choice):這封信分給帳務、物流還是技術?回一個選項加各選項的機率。
- 幾分(Score):客人的火氣 1 到 5?回一個等級加機率。
- 是不是(Noul):這是不是釣魚信?回一個 0 到 1 的機率。
一次可以問幾十題,它同時答,題目多了幾乎不多花時間。
快跟便宜都是從「不生字」來的。TypeSafe 自己給的數字:0.07 到 0.5 秒回,一般模型同類工作 3 到 329 秒;輸入每百萬 token 0.042 美元,輸出不收錢,「too cheap to meter」。這些是它自己測的,下面社群的案例會給你當事人的數字。
代價是它真的什麼都不會寫。你要它解釋為什麼,它給不出來;要它寫一封回信,它做不到,那是 ChatGPT 的事。
一個韓國讀者的比喻我覺得最準:一般模型是申論題作答機,Jev 是選擇題作答機。選擇題不會亂編答案,但選錯還是會選錯。
這一週社群拿它做了什麼
Jev 開放早期存取一週,一份網友整理的清單 awesome-jev 已經收了超過 240 個專案,Threads 上中文貼文我抓到四十幾則。我挑十個一般人看得懂的,數字都是當事人自己說的,連結在後面。
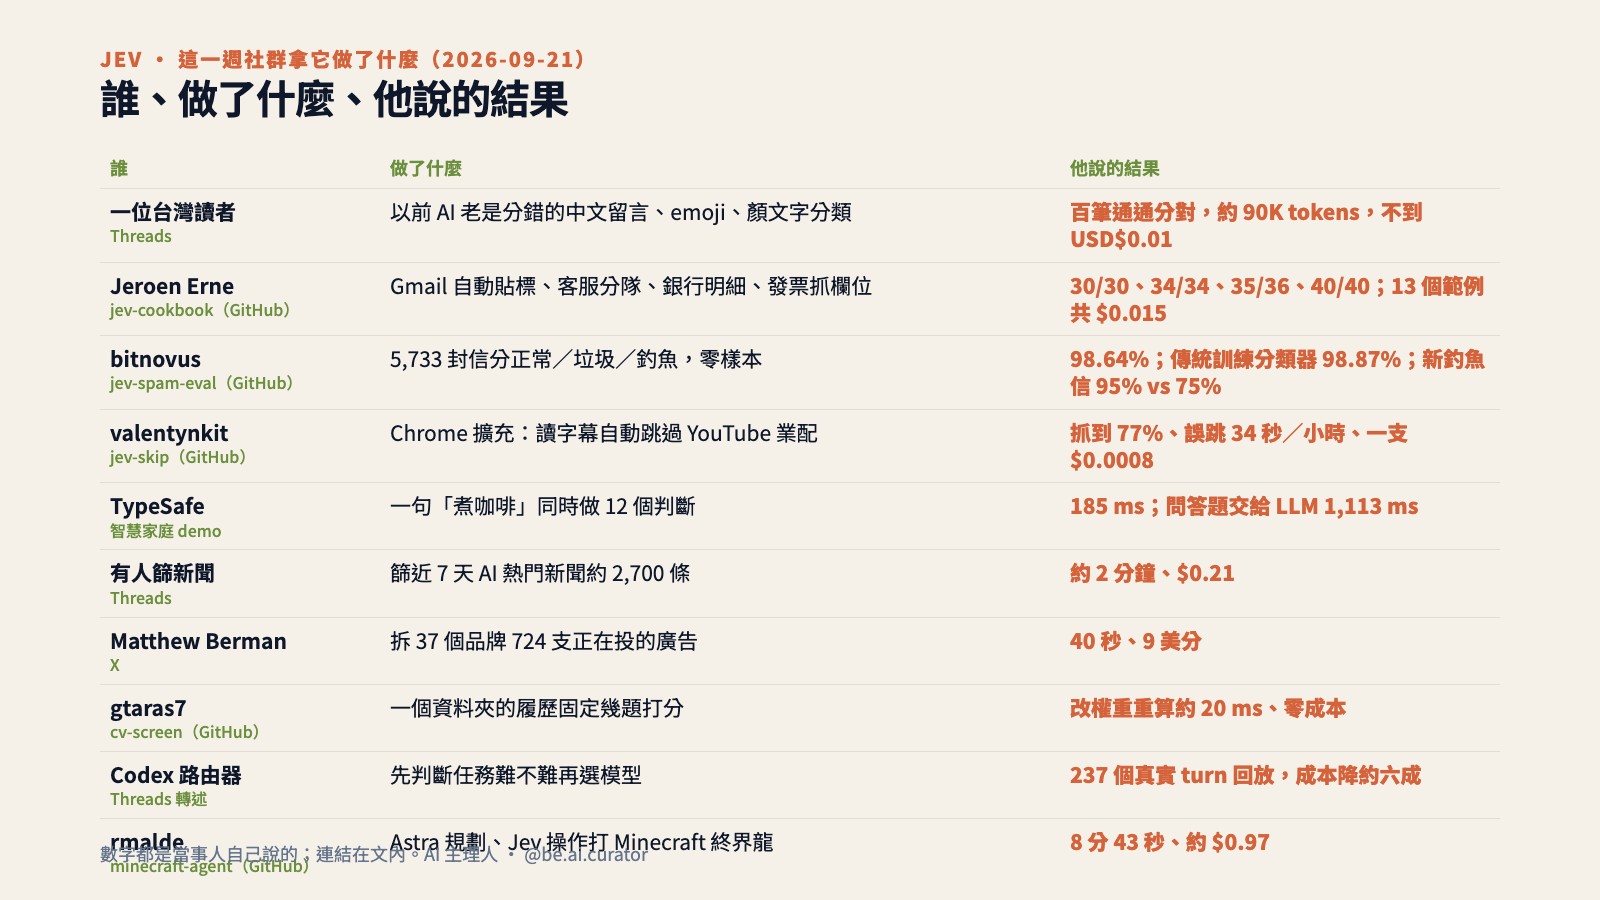
中文留言分類。 @user.today15 排到 waitlist 當天,把以前 AI 老是分錯的高難度中文留言丟給它:「喔虧給過」、一串 😍、顏文字,他說「通通分類正確」,跑了百筆訊息,token 約 90K,「花費不到 USD$0.01」。
Gmail 自動貼標、銀行明細、發票。 Jeroen Erne 把 15 個日常小工作的範例連資料一起公開在 GitHub:客服信分隊 34 封全對,真的模糊的那幾封信心掉到 0.60 到 0.67,交給人;Gmail 貼標 30 封全對、3 封釣魚信零誤判;銀行明細分類 36 筆對 35 筆;發票抓欄位 40 個全對。13 個範例跑完總共 0.015 美元,單次中位 0.34 到 0.45 秒。
垃圾信跟釣魚信。 bitnovus 拿 5,733 封信測,零樣本,給它信裡的連結去向、Reply-To、附件資料之後 98.64%;一個用幾千封信訓練過的傳統分類器 98.87%,只差 0.2 個百分點。2024 年以後的新釣魚信 853 封,它抓到 95.31%,傳統的 75.26%。9,886 封跑完約 252 秒,他估約 1.35 美元。
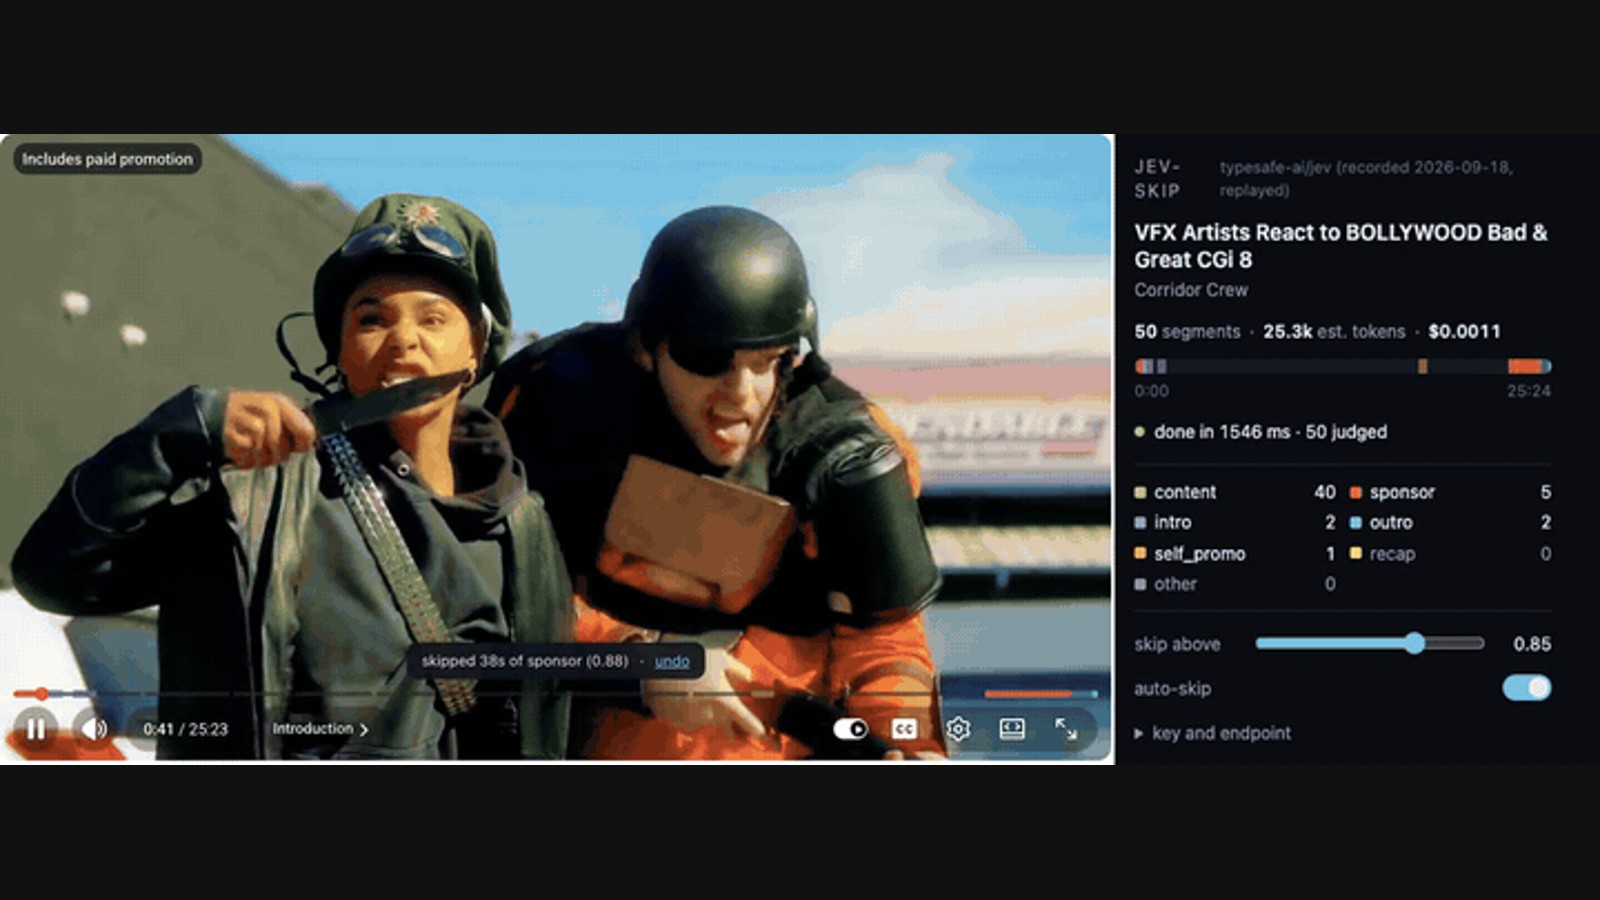
YouTube 自動跳業配。 valentynkit 做了 Chrome 擴充,讀字幕就能判斷哪段是業配,連沒人標過的影片也行:抓到 SponsorBlock 群眾標記的 77% 業配秒數、每小時誤跳 34 秒、一支影片 0.0008 美元、0.9 秒回答。
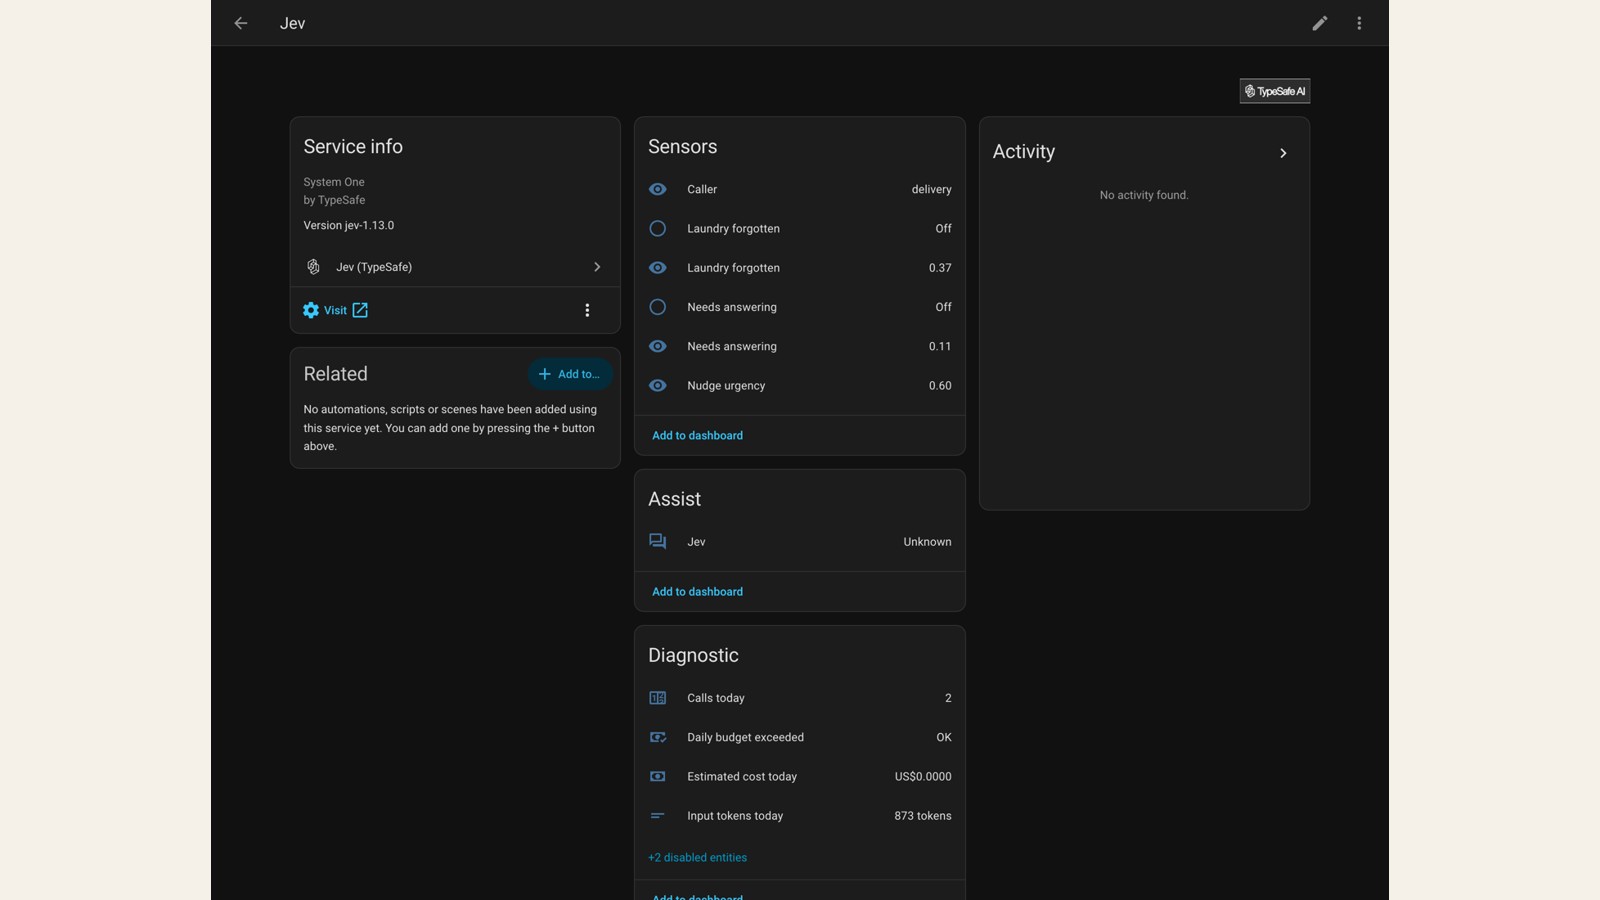
智慧家庭。 TypeSafe 自己的示範:一句「Get the coffee boiling」(把咖啡煮起來)同時做 12 個判斷(是指令還是問題、哪個裝置、哪個房間、開還是關),畫面上寫 185 毫秒;問它「1989 年世界大賽誰贏」它判斷是問答題,交給一般模型答。有人把這套接進 Home Assistant,每個問題變成一個感測器(下圖是他 README 裡的畫面,MIT);AboveColin 算一條指令 0.0001 到 0.0007 美元,也寫了「歐洲打過去比 TypeSafe 說的慢,門鈴夠用、緊迴圈太慢」「不拿來做安全決策」。
篩新聞。 @x_yyyole 拿它篩近 7 天的 AI 熱門新聞,接近 2,700 條逐條判斷,「最后用时 2min 左右」「成本 0.21 美元」。
拆廣告。 Matthew Berman:「in 40 seconds it broke down 724 live ads from 37 brands. every hook. every format. offer. cta. awareness stage. landing page mismatch. used 9 cents of tokens.」台灣轉述那則有五百多次分享。
篩履歷。 gtaras7 把一整個資料夾的履歷固定幾題問完打分,判斷跟算分分開存,改一個權重重算全部候選人約 20 毫秒、零成本。
打遊戲。 TypeSafe 發表文裡讓它玩 DOOM,每秒 10 次判斷;有人拿 GPT-6 Astra 當規劃、Jev 當即時操作,8 分 43 秒打完 Minecraft 終界龍,約 0.97 美元。這類不是一般人會做的事,但它讓你看到「快到什麼程度」。
幫大模型省 token。 這個放下一段,因為是我自己的痛。
我自己的痛:Astra 跟 Fable 5.1 太好用也太燒
GPT-6 Astra 跟 Claude Fable 5.1 出來之後,同樣的 effort、同樣的任務量,我連續兩週都在重置後第二、三天用到上限,以前不會。仔細看它們在燒什麼,很多是圍在寫程式旁邊的小判斷:這件事交給哪個模型、用多大力氣想、對話裡哪段還要留、做完了沒、這個工具要不要叫。
這一週社群上的玩法就是把這些小判斷搬給 Jev:
- 先判斷再叫模型。 有人做了 Codex 的路由器,Jev 先判斷這個任務難不難,簡單的給便宜模型、難的才叫強的;他拿 237 個真實對話回放,算出成本降了約六成。
- 上下文回收。 Claude Code 用久了,讀檔、跑指令、搜尋的結果會把對話塞滿,一般做法是叫大模型寫摘要,摘要會不小心丟掉檔案路徑跟錯誤訊息。開源專案 fast-jev-compaction 改讓 Jev 判斷每次工具呼叫「還重要嗎、完整結果還要留嗎」,指令跟回覆保留原文。
- 大模型給目標、Jev 做手腳。 @yinn__nkai 讓 Jev 判斷任務狀態、風險、該點哪個按鈕,大模型只給目標,他說「省下 50-80% 的 token」。
- TypeSafe 的文件把這整類用法叫 Harness Engineering:模型路由、找相關上下文、抓大模型的錯、把推理過程分類,「at lightspeed and a fraction of the cost」。
它省的是圍在寫程式旁邊那堆小決定。這些變便宜,大模型就只做該做的事。這是我覺得 Jev 對一般用戶最實際的價值,比它自己說的「快 100 倍」實際。
三桶冷水
第一,格式一定對,答案不一定對。 TypeSafe 說它「can't hallucinate」,講的是它只會從你給的選項裡選,不會編出第四個選項。選錯還是會選錯。scienthoon 做了一個獨立測試:三個公開題庫它答對 86% 到 94%,機率幾乎不用校正;但 900 張它沒看過的規則工單,規則猜不到的地方它「confidently wrong」,跟一般分類器一樣。我自己第一次打就踩到一個更小的版本:我給的四類裡沒有「抱怨」,一則客訴它就在閒聊跟問問題之間猶豫,0.6 對 0.4;選項沒列到的,它選不到。4,621 次呼叫零格式錯,整個測試約 0.06 美元。所以信心分數是拿來設「低於多少交給人」的門檻,不是拿來相信。
第二,中文沒英文準。 TypeSafe 的模型頁原句:「English is the primary training language and where accuracy is currently best. Other languages, including CJK scripts, are handled but not equally well」。上面那位分中文留言的是他的百筆體感,不是統計。有人經 OpenRouter 跑了約 1,430 次專門測中文,作者自己說「這些數據能看出兩個條件之間有沒有差別,得不出準確率」。要用在中文上,先拿自己的資料跑一小批。
第三,會不會下個月就被吸收。 @linkenmin 說「Jev 感覺是另一個不用學的酷東西,因為下個月就會被一般 LLM 吸收了」,227 個讚、45 則回覆。Hacker News 發表串最多人回的一則也在講:速度比較有誤導,生成模型能寫程式做任何事,Jev 只能出結構化答案。我的看法:吸不吸收不知道,已經有人用開源小模型做出類似的東西:一個叫 Laya 的開源模型,作者說單題最低 32.8 毫秒;還有一位網友一個下午用 0.8B 模型「部份復刻」。但「不是每件事都要叫最強的模型」這件事不會被吸收,只會越來越像常識。
還有幾件 TypeSafe 寫在文件裡的邊界:它只吃文字,不吃圖片、聲音、影片;一次最多 32k token 的內容;它不是計算機,數學請寫在程式裡;它不會用你的資料微調,所有帳號用同一組權重。早期存取要排隊,金鑰在 console.typesafe.ai。
你不寫程式怎麼申請、怎麼接
我自己走了一遍,現在不用排候補名單。
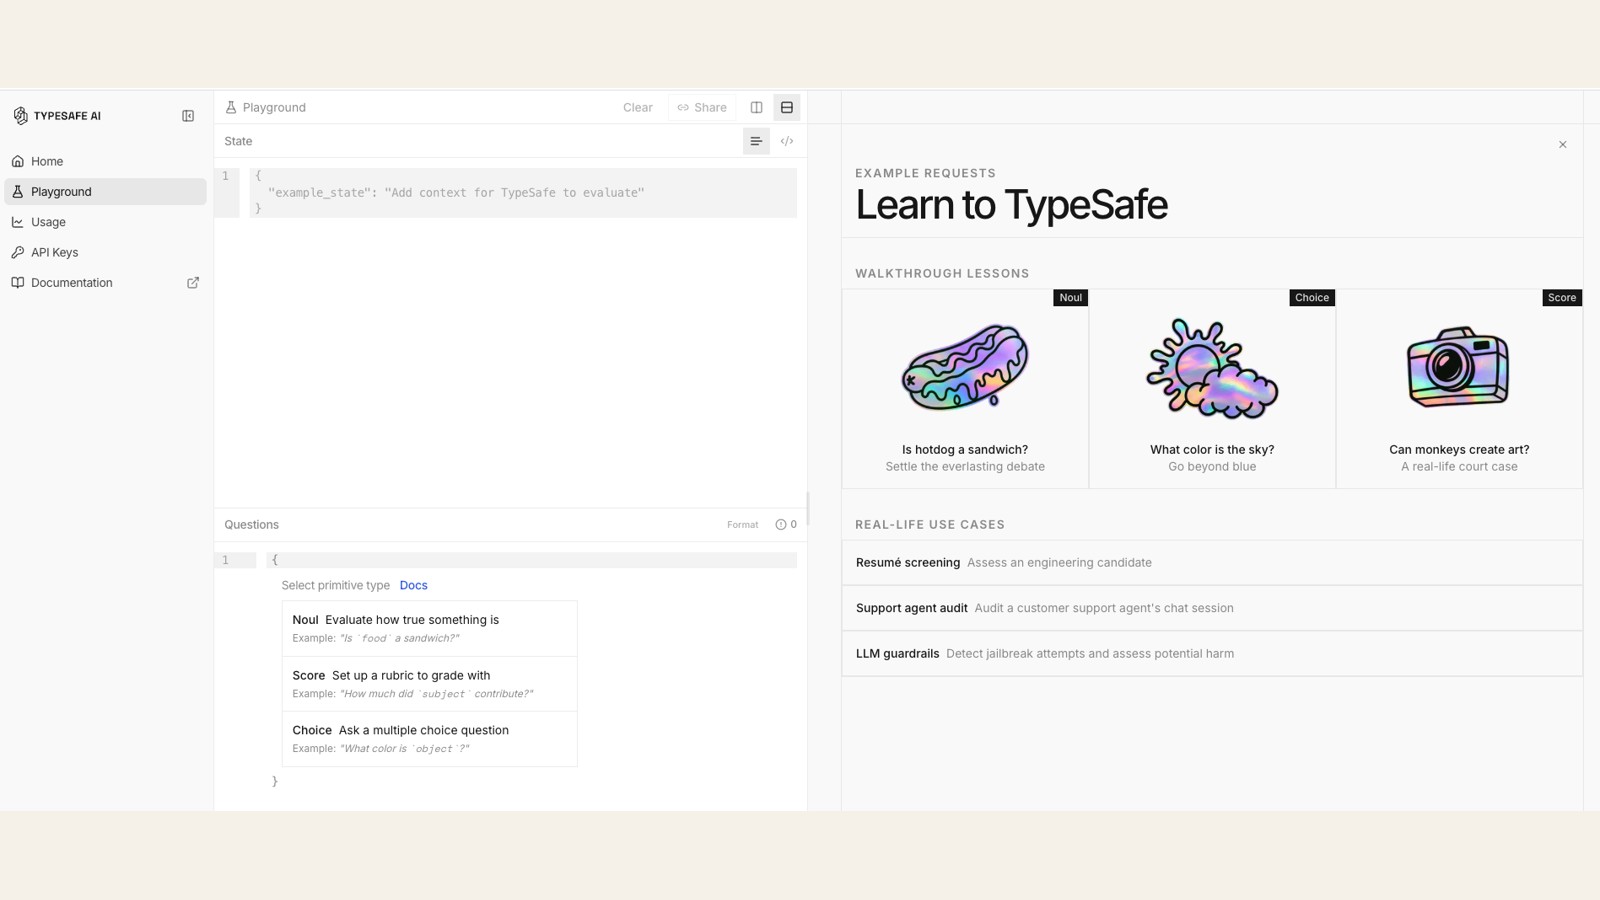
- 到 console.typesafe.ai 註冊。進去先做一個小的 onboarding,會問你「Jev 會不會跟你聊天?」,選不會。
- 左側 API Keys 申請一把金鑰,存好,不要貼在對話或截圖裡。
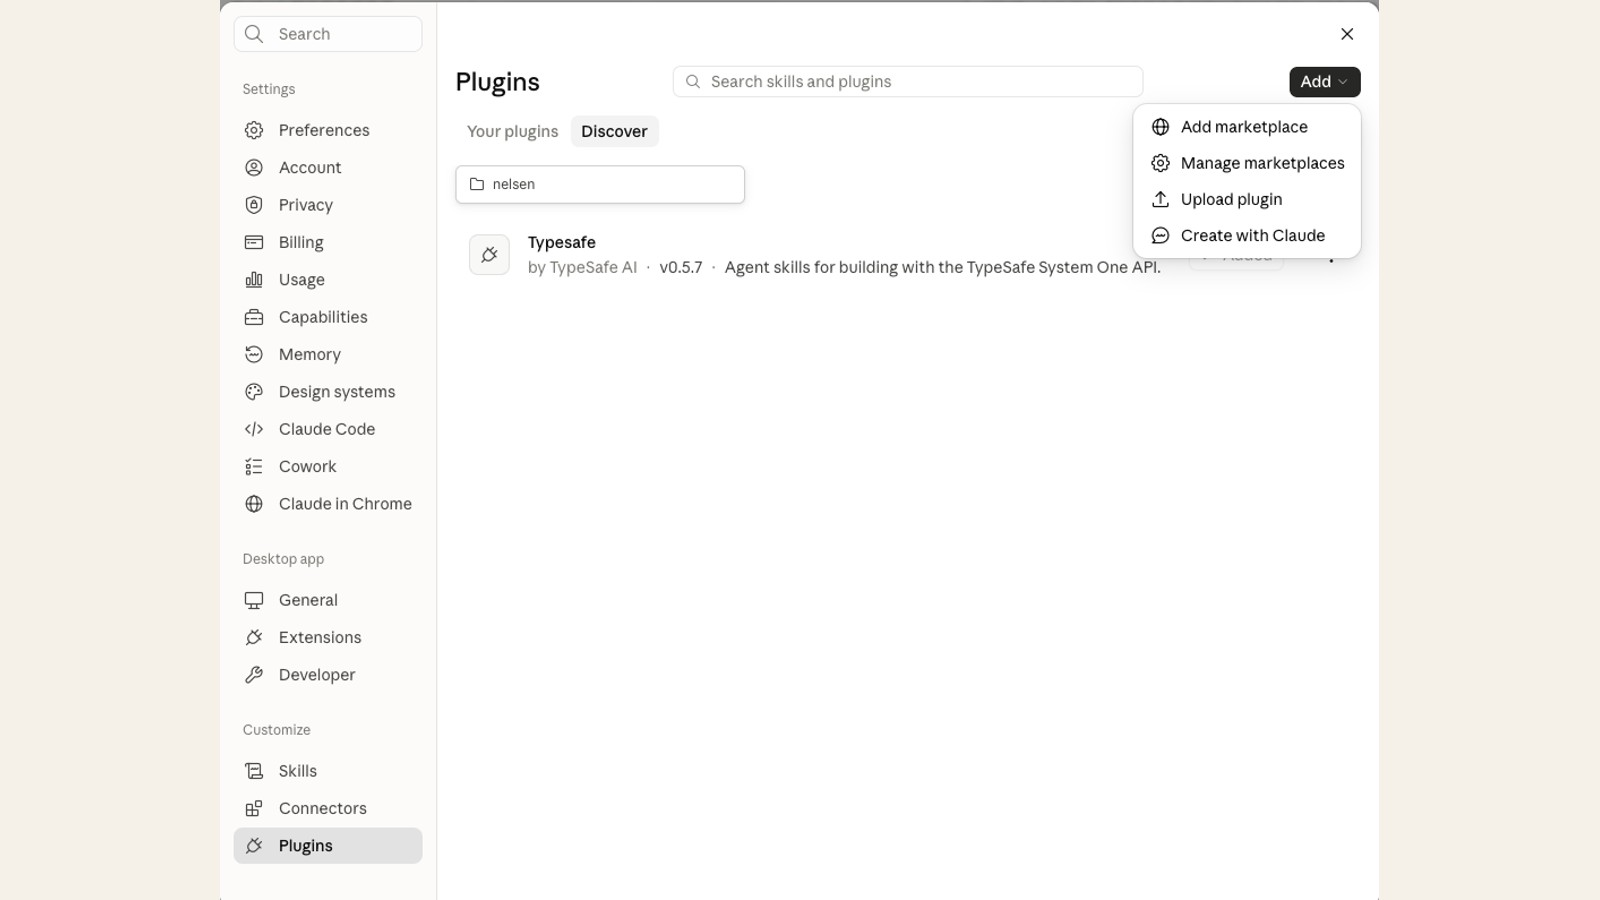
- 打開 Claude 桌面版,設定 → Plugins → Discover 搜「Typesafe」,是 TypeSafe AI 自己出的,按 Add。Claude Code 的話跑兩行指令:
claude plugin marketplace add typesafe-ai/skills、claude plugin install typesafe@typesafe-ai。 - 用量在 console 的 Usage 頁看,上面寫「$0.042/MTok input · Free output」。我 9 月 21 日的帳號一毛沒儲值,Usage 顯示 $0.00。同一天我用金鑰直接打了一次:一則客訴問三題(是不是釣魚信、火氣幾分、分給誰),562 毫秒回三個字,549 個輸入 token,照標價算 0.000023 美元;零儲值打得通,但外掛那條路我還沒走。
裝好之後,用講的。你打開 Claude,貼這段:
幫我裝 TypeSafe 的 skill:跑 claude plugin marketplace add typesafe-ai/skills,再跑 claude plugin install typesafe@typesafe-ai。裝好之後,我要你用 Jev 幫我做一件事:把我貼給你的 300 則留言分成四類(問問題、要資源、閒聊、廣告),每則給我類別跟機率,機率低於 0.7 的另外列出來我自己看。開始前先跟我確認四類的定義。TypeSafe 的文件自己說「Agents aren't great at writing questions, so expect to edit collaboratively with them.」所以最後一句「先跟我確認定義」很重要。至於 Codex 那邊,就讓 Claude 讓 Jev 判斷要不要叫吧。另一條路:Vercel AI Gateway 也掛了 typesafe-ai/jev,頁面上寫價格 Free、「Promotional pricing ends on September 25, 2026」。
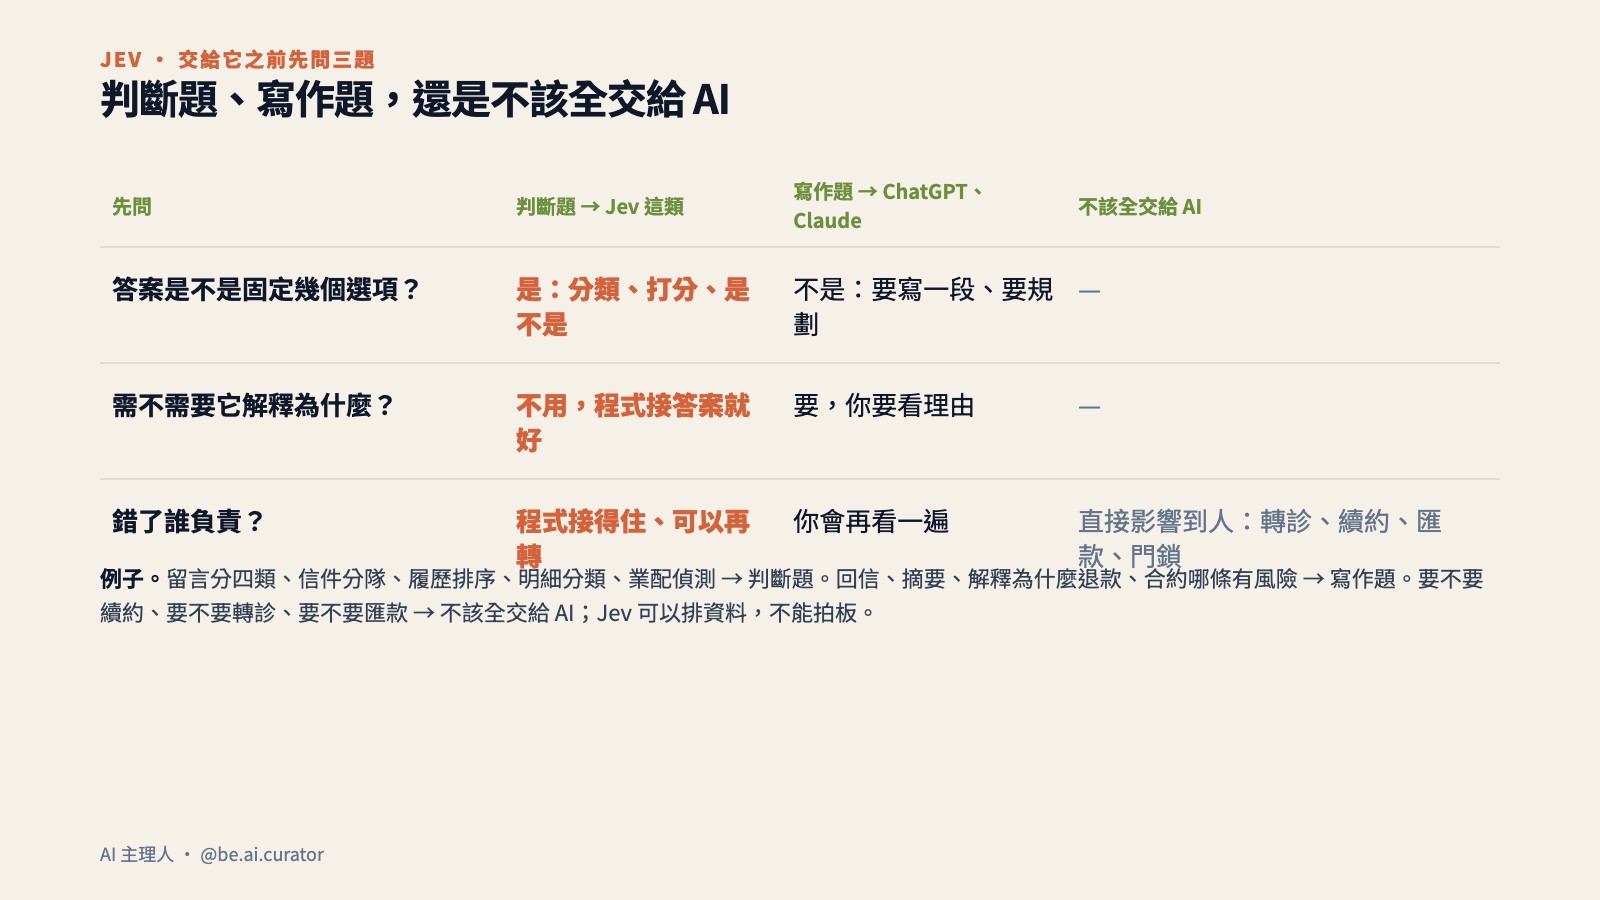
交給它之前,先分清楚這件事是判斷題還是寫作題。貼給你的 ChatGPT 或 Claude,它會先問你三題:
我想把一件工作交給 AI,先問我三題,一次問完:(1) 這件事的答案是不是固定幾個選項(例如分類、打分、是或不是)?
(2) 我需不需要 AI 解釋它為什麼這樣選?(3) 它選錯了會怎樣,是程式接得住、還是會直接影響到人?
只用下面的事實回答,這裡沒寫的答「沒提到」:
- Jev 只做三種題:哪一個、幾分、是不是;回答案跟機率,不寫字、不解釋
- 它自己說 0.07 到 0.5 秒回、輸入每百萬 token 0.042 美元、輸出免費;數字是 TypeSafe 自己測的
- 格式一定對,答案不一定對;沒看過的規則會很有把握地答錯;信心分數要拿來設「低於多少交給人」
- TypeSafe 寫英文最準,中文「handled but not equally well」
- 只吃文字,一次最多 32k token;不是計算機
根據我的三個答案,只回兩件事:(a) 這件事是「判斷題(適合 Jev 這類)」「寫作題(適合 ChatGPT/Claude)」還是「不該全交給 AI」,一句理由;
(b) 如果是判斷題,幫我把它寫成一題「哪一個/幾分/是不是」,選項列出來,20 字內。
這週能做的三件事
- 想一件你每天叫 AI 做、其實只需要它回一個字的事。 留言分類、信件分流、履歷先後、要不要回。
- 去 console.typesafe.ai 申請金鑰、在 Claude 裝 Typesafe 外掛,用講的接上。 拿 50 筆自己的資料先跑,看信心分數低的那幾筆是不是真的難。
- 交給它之前先問三題。 答案固定、不用解釋、程式接得住,才是判斷題。
這篇的案例全部來自當事人的公開貼文、GitHub 專案與 TypeSafe 的文件跟示範影片;申請與安裝那段是我自己的帳號走過一遍的畫面;哪一段是我的判斷,我有寫「我覺得」。
二十個日常判斷題哪些該丟給它、案例原始數字表(速度、成本、準確率、誰說的、日期)、TypeSafe 沒說的,整理成一頁:哪些事該丟給 Jev:二十個日常判斷題對照、案例原始數字、TypeSafe 沒說的。
來源與查核日期
- TypeSafe AI Blog — Introducing System One Models & Jev(2026-09-15):Diogo Almeida 自述、RLCD、價格、速度、DOOM
- TypeSafe Docs — Primitives:Choice/Score/Noul
- TypeSafe Docs — Models:價格、額度、32k、只吃文字、語言支援原句
- TypeSafe Docs — Model jaggedness jev-1.13:不生字、不是計算機
- TypeSafe Docs — Agent skill:Claude Code/Codex 安裝指令、「Agents aren't great at writing questions」
- TypeSafe Docs — Use case map:Harness Engineering
- TypeSafe Docs — Smart home demo:Loom 示範
- Vercel AI Gateway — Jev:Free、9/25 promotional pricing
- Hacker News — Introducing System One Models and Jev
- yibie/awesome-jev:社群專案清單
- 案例:nexibeo/jev-cookbook、bitnovus/jev-spam-eval、valentynkit/jev-skip、AboveColin/HA-Jev、gtaras7/typesafe-jev、rmalde/minecraft-agent、scienthoon/jev-ood-calibration、xiaohuaxi/jev-study
- Threads/X:@user.today15、@x_yyyole、@yinn__nkai、@linkenmin、@TheMattBerman(連結在文內)
查核日 2026-09-21(Asia/Taipei)。